


大模型训练与科学计算对存储吞吐和延迟提出了严苛要求,智算中心在规划存储层时,往往面临性能与预算的双重压力。作为直接承载GPU数据供给的关键部件,智算中心工业NVMe盘的选型与成本结构,直接影响整体算力利用率与项目回报。本文从预算构成、分项报价、档位对比到省钱策略,逐层拆解智算中心工业NVMe盘的投入逻辑,结合世通贝尔在分布式存储与AI算力配套中的实践经验,为政企客户提供一份可落地的选型参考。
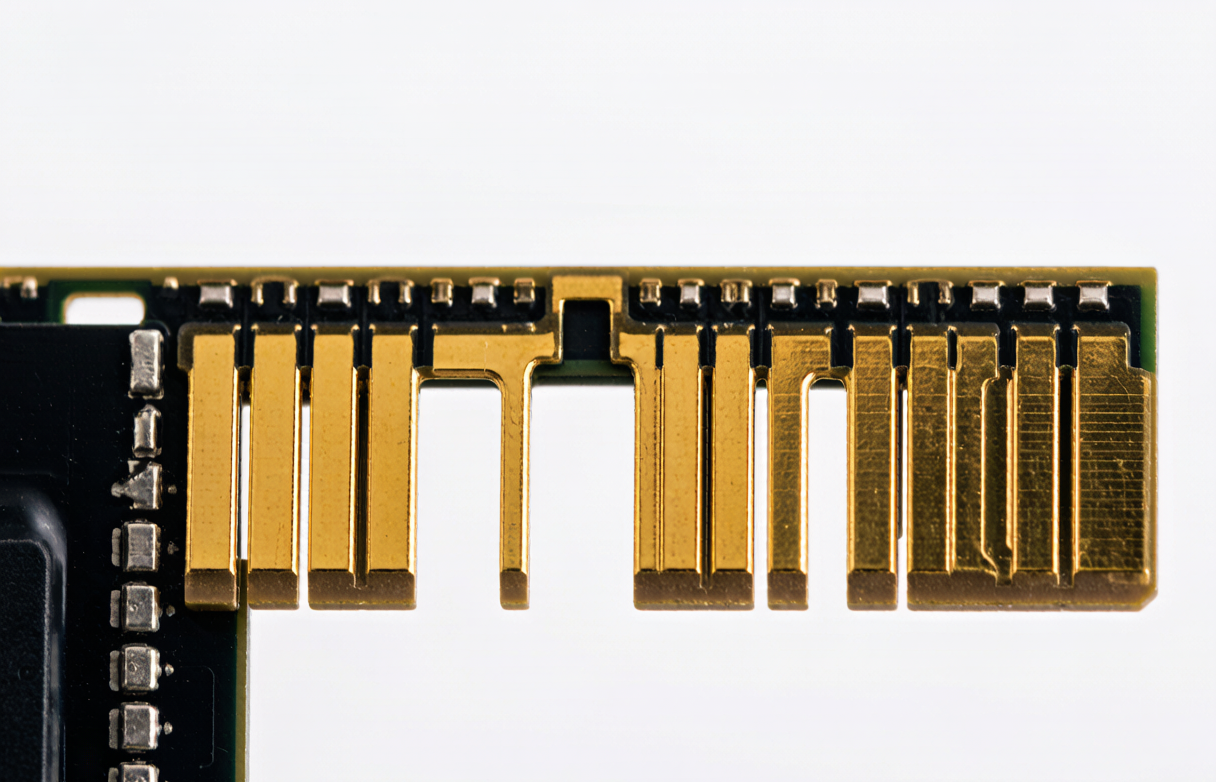
另一个容易被低估的预算项是容灾与数据保护。智算中心承载、Checkpoint和推理结果,一旦盘体故障导致训练中断,损失远超硬件本身。工业NVMe盘支持断电保护(PLP)、端到端ECC和盘内RAID等特性,这些功能会体现在盘体单价中,但相比训练任务重启的时间成本,属于必要投入。世通贝尔的分布式存储方案支持2副本/3副本及EC纠删码,在单点硬盘故障、节点故障甚至机柜级故障时数据不丢失、业务不中断,这部分软件与架构成本也应纳入总预算。此外,智算中心工业NVMe盘的运行环境往往不是恒温恒湿的标准机房。边缘推理节点、工业现场机柜可能面临-40~85℃的宽温挑战,抗冲击1500G、抗振动20G@7-2000Hz等工业指标意味着盘体需要经过更严格的筛选与验证。这些工业级特性会拉高单盘采购价,但能显著降低7×24小时高负荷运行下的故障率,从全生命周期看反而更经济。预算编制时,建议将盘体、节点、网络、软件、运维五部分分别列项,避免后期因某一环节超支而压缩盘体品质。
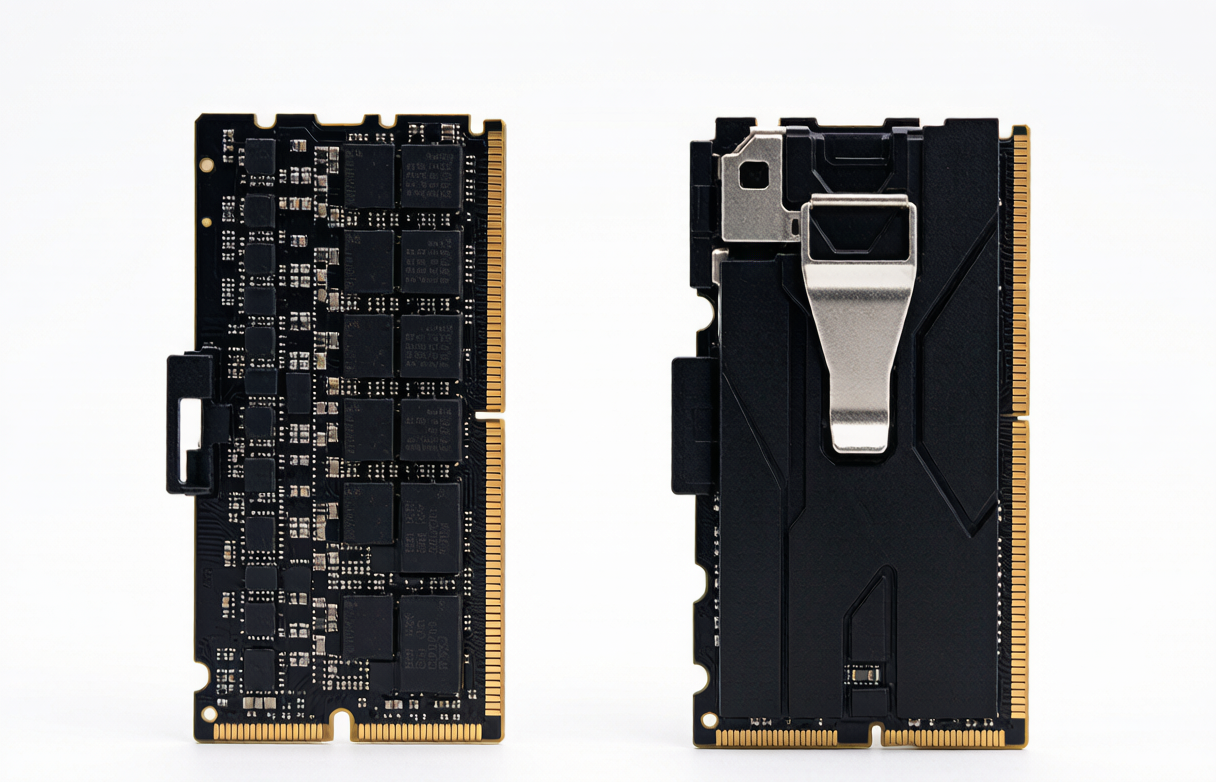
除了盘体本身,分项报价还应包含配套的硬件与软件。世通贝尔存储与AI算力服务提供工业宽温存储全品类配套,客户无需投入大量人力进行硬件选型与兼容性测试,可直接获得适配自身场景的高可靠存储方案,缩短项目前期准备周期30%以上。这意味着在分项报价中,兼容性测试、固件调优、驱动适配等隐性人力成本可以被显著压缩。同时,原厂直供的售后保障有助于降低7×24小时不间断运行场景下的设备故障率。网络配套方面,RoCE/InfiniBand网络方案需要与智算中心工业NVMe盘的吞吐能力匹配。若盘体顺序读达到7100 MB/s,网络带宽和交换机端口配置必须同步跟上,否则盘体性能无法转化为GPU可用带宽。世通贝尔的AI算力服务可提供GPU服务器及网络配套方案,实现秒级加载、Checkpoint快速落盘,将GPU利用率从60%提升至90%以上。这部分网络成本通常占存储相关总预算的15%至25%,具体取决于节点规模和拓扑结构。软件与运维分项包括分布式文件系统授权、容灾软件、智能运维平台等。世通贝尔方案支持智能数据分层与冷热归档,根据访问频率自动将热数据放在高速NVMe、温数据放在SSD、冷数据归档到低成本介质,整体存储成本降低30%以上。智能运维与故障预测通过硬盘SMART、IO latency、温度等多维指标实时监控,提前预测潜在故障并自动迁移数据,将非计划停机时间降低80%以上。这些软件能力虽然不直接体现在盘体单价上,却是智算中心工业NVMe盘发挥价值的关键保障,建议在预算中单独列项。
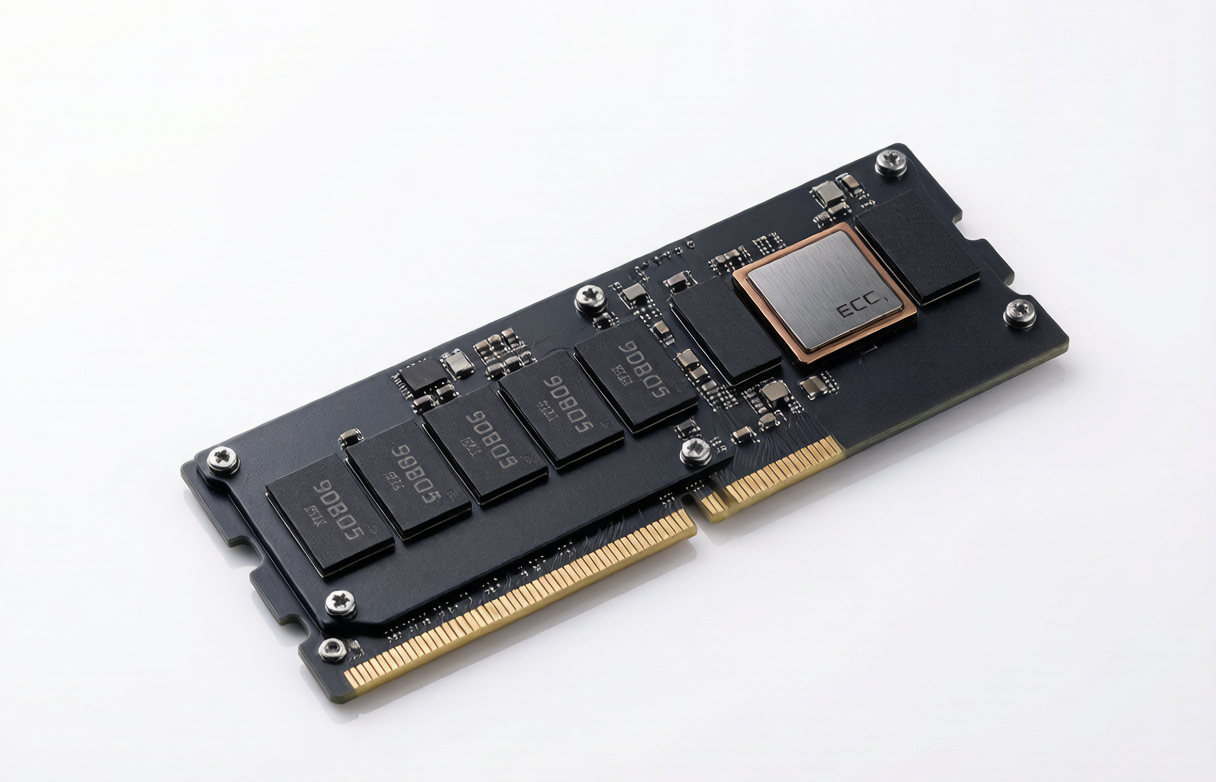
从对比维度看,SATA SSD与NVMe盘的差异同样适用于智算中心场景。SATA SSD走SATA总线,速度上限约550 MB/s,延迟较高;而NVMe盘走PCIe总线,顺序读可达7000+ MB/s,延迟更低,适合边缘服务器与机器视觉等需要低延迟大带宽的负载。SATA SSD够用且便宜,适合普通工控机或对性能不敏感的冷数据存储。在智算中心工业NVMe盘的预算分配中,可以将SATA SSD用于冷归档,将NVMe盘集中在热数据和Checkpoint路径,实现成本与性能的平衡。世通贝尔的智能数据分层与冷热归档能力,正是基于这一逻辑:根据访问频率自动将热数据放在高速NVMe、温数据放在SSD、冷数据归档到低成本介质,整体存储成本降低30%以上,同时保证热业务低延迟。这种分层策略让高档智算中心工业NVMe盘不必承担全部存储容量,而是聚焦于最需要性能的环节。对于政企客户而言,这意味着可以在总预算不变的情况下,通过架构优化获得更高的有效吞吐。在容灾与扩展性方面,不同档位方案都需要考虑多副本与纠删码容灾。世通贝尔分布式存储支持2副本/3副本及EC纠删码,在单点硬盘故障、节点故障甚至机柜级故障时数据不丢失、业务不中断,满足金融与政务合规要求。存储性能线性扩展采用分布式架构,节点随容量与性能需求弹性扩容,无需停机即可从数百TB扩展到PB级,性能随节点数近线性增长。无论选择哪一档智算中心工业NVMe盘,都应确保存储架构具备这种弹性,避免后期扩容时推翻前期投资。
第四条建议是关注盘体的耐久度与质保周期,而非单纯比较每TB单价。智算中心工业NVMe盘的TBW和P/E指标直接决定使用寿命,TLC 3000 P/E、TBW最高5200 TB(TLC)或24000 TB(SLC)的盘体,虽然单价较高,但在高写入负载下寿命更长,摊薄到每年的成本可能更低。PCIe Gen3x4 / NVMe 1.4档位提供5年质保,MTBF 2,000,000小时,适合写入频率中等的场景。采购方应根据业务写入模型计算全生命周期成本,而不是只看初始报价。第五条建议是采用分布式架构实现性能线性扩展,避免一次性过度采购。世通贝尔存储性能线性扩展采用分布式架构,节点随容量与性能需求弹性扩容,无需停机即可从数百TB扩展到PB级,性能随节点数近线性增长。这意味着智算中心可以先按当前业务规模采购智算中心工业NVMe盘,后期随算力需求增加逐步扩容,降低一次性硬件投入压力。对于中小型AI项目,还可以通过算力租赁对接方式降低一次性硬件投入成本70%以上,灵活匹配项目不同阶段的算力需求。最后,数据加密与访问审计、云边协同统一纳管等能力也应纳入成本考量。世通贝尔方案支持传输加密、静态加密、多租户隔离及操作审计日志,满足等保2.0、金融行业信息安全等级保护三级等合规要求。云边协同统一纳管让总部私有云与分支机构边缘节点通过统一管理平台协同,策略下发、固件升级、告警收敛一站式完成,降低分布式运维复杂度。这些能力减少的是长期运维成本,在智算中心工业NVMe盘的预算规划中应作为隐性收益纳入评估。
Q1: 智算中心工业NVMe盘和普通商用NVMe盘有什么区别?
A: 智算中心工业NVMe盘面向7×24小时高负荷运行,强调宽温、断电保护和耐久度。普通商用盘工作温度通常为0~70℃,而工业NVMe盘可达-40~85℃,并支持断电保护(PLP)、端到端ECC和抗硫化G3。以世通贝尔配套的工业NVMe盘为例,PCIe Gen4x4档位顺序读7100 MB/s,TBW最高4800 TB,3000 P/E,具备OCP/OVP保护和盘内RAID;PCIe Gen3x4档位提供5年质保,MTBF 2,000,000小时。这些工业特性直接降低智算中心非计划停机风险。
Q2: 智算中心工业NVMe盘选PCIe Gen3还是Gen4?
A: 取决于GPU数据供给带宽和预算。PCIe Gen4x4 / NVMe 2.0的智算中心工业NVMe盘顺序读可达7100 MB/s,顺序写6400 MB/s,适合大模型训练热数据和Checkpoint高频落盘;PCIe Gen3x4 / NVMe 1.4档位顺序读2000 MB/s,顺序写1500 MB/s,适合推理集群和温数据存储。若节点PCIe通道和网络带宽充足,Gen4能更充分释放GPU算力,将GPU利用率从60%提升至90%以上;若预算有限或网络为瓶颈,Gen3方案性价比更高。
Q3: 智算中心工业NVMe盘的TBW和P/E寿命怎么理解?
A: TBW是总写入量,P/E是擦写次数,两者共同决定盘体寿命。世通贝尔配套的工业NVMe盘中,PCIe Gen3x4的TLC方案可提供最高5200 TB(TLC)甚至24000 TB(SLC)的总写入量;PCIe Gen4x4档位TBW最高4800 TB,擦写寿命3000 P/E;PCIe Gen3x4 / NVMe 1.4档位采用TLC 3000 P/E,质保5年。智算中心应根据每日Checkpoint写入量和更新频率计算年写入量,选择TBW留有合理余量的型号,避免过早耗尽寿命。
Q4: 智算中心工业NVMe盘如何与分布式存储配合省钱?
A: 核心是按数据温度分层。世通贝尔方案支持智能数据分层与冷热归档,根据访问频率自动将热数据放在高速NVMe、温数据放在SSD、冷数据归档到低成本介质,整体存储成本降低30%以上。智算中心工业NVMe盘聚焦热数据和Checkpoint路径,冷数据用低成本介质承载。同时分布式架构支持节点弹性扩容,无需停机即可从数百TB扩展到PB级,性能随节点数近线性增长,避免一次性过度采购。
智算中心工业NVMe盘的预算拆解,本质是在性能、可靠性与成本之间寻找匹配业务需求的平衡点。从总预算构成到分项报价,从高中低档方案对比到分层存储、信创适配、弹性扩容等省钱策略,每一环节都需要结合GPU算力调度和实际写入模型来决策。世通贝尔存储与AI算力服务提供全闪NVMe分布式存储、GPU服务器及RoCE/InfiniBand网络配套方案,支持智能数据分层、多副本与纠删码容灾、国产化信创适配,帮助政企客户在控制预算的同时,实现秒级加载与Checkpoint快速落盘。选型时建议以全生命周期成本为尺度,让智算中心工业NVMe盘真正成为提升算力利用率的支点。